Almacenamiento en memoria compatible con Redis con búsqueda de vectores nativa
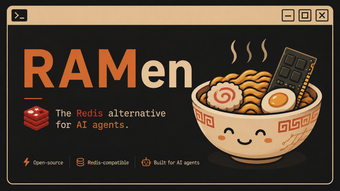
RAMen, de Rohit Dnath, es un almacén de datos en memoria diseñado para soportar flujos de trabajo impulsados por IA y memoria de agentes. La herramienta acepta acceso estilo clave-valor mientras añade recuperación semántica para que las aplicaciones puedan obtener contenido por significado en lugar de coincidencias exactas. Está dirigida a desarrolladores de IA e ingenieros de backend que necesitan un almacén local para reducir la latencia y evitar llamadas repetidas al modelo, e integra con ecosistemas de agentes que utilizan un protocolo para el intercambio de contexto del modelo.
¿Para qué tareas puedes usarlo realmente?
La herramienta funciona como un almacén en memoria que combina el acceso estilo Redis con la recuperación vectorial y semántica para cargas de trabajo de IA. Acepta comandos del protocolo Redis, expone almacenamiento en caché semántico para búsquedas basadas en significado y ejecuta un servidor del Protocolo de Contexto de Modelo que los agentes pueden consultar directamente. La implementación central está escrita en Go y optimizada para rendimiento en memoria, por lo que los casos de uso incluyen recuperación local rápida para la memoria del agente, contexto de sesión y respuestas de LLM en caché.
¿Qué tan precisa es la recuperación semántica para flujos de trabajo de IA?
El almacenamiento en caché semántico almacena y recupera respuestas de IA basadas en significado en lugar de coincidencias exactas de palabras clave, un diseño destinado a reducir las llamadas a LLM y disminuir la latencia durante la recuperación. La búsqueda vectorial nativa maneja incrustaciones de alta dimensión para soportar esas búsquedas. Las salidas reflejan la calidad del índice y de la incrustación, por lo que los equipos deben validar las respuestas en caché contra sus datos de aplicación antes de confiar en ellas para decisiones fácticas o de alto riesgo.
¿Qué entornos y clientes soporta?
El modelo de distribución es un único binario de Go, lo que simplifica el despliegue en sistemas que pueden ejecutar programas de Go. La herramienta implementa un protocolo Redis de fácil integración para que los clientes y bases de código existentes de Redis puedan interactuar sin modificaciones significativas. Para flujos de trabajo de agentes, se integra con cualquier cliente o plataforma de IA que soporte el Protocolo de Contexto de Modelo, con ejemplos nombrados que incluyen Claude Desktop y Cursor, permitiendo acceso directo a datos desde los agentes.
¿Es fácil de adoptar en pilas existentes?
La adopción se centra en la ergonomía del desarrollador y la preparación de código abierto. La licencia BSD-3-Clause y un proyecto alojado en GitHub hacen que la reutilización del código sea sencilla, y la experiencia del desarrollador en sistemas backend, Node.js, TypeScript y Go sugiere un énfasis en la disciplina de API y despliegue. Dado que la herramienta está dirigida a ingenieros y constructores de agentes de IA, se espera un flujo de trabajo orientado al desarrollo que favorezca la integración de repositorios, la configuración a nivel de código y las pruebas iterativas en lugar de la administración gráfica.
Quién debería considerar esta herramienta
La herramienta es una elección pragmática para equipos de ingeniería que construyen servicios respaldados por agentes que necesitan recuperación local y control del desarrollador. Su orientación de código abierto apoya la integración impulsada por repositorios, pero los equipos deben validar las salidas de la caché semántica contra sus conjuntos de datos y confirmar que sus agentes pueden acceder al almacén a través del protocolo de contexto requerido antes de implementar a gran escala. Trátalo como un componente de ingeniería, no como un producto final listo para usar.